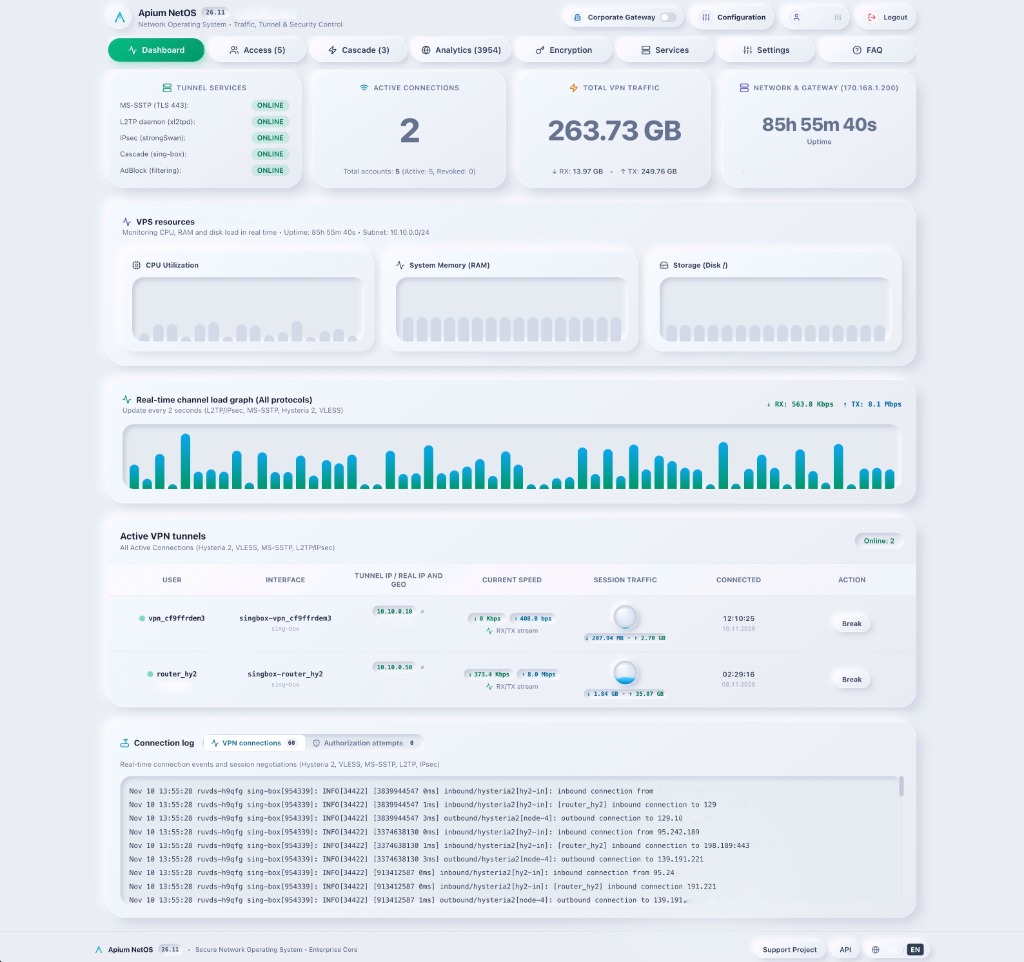
1. Два полностью изолированных режима платформы
В отличие от обычных прокси-панелей, где все пользователи и правила свалены в одну таблицу базы данных, Apium Cloud OS поддерживает два архитектурно разделённых режима работы на одном шлюзе:
- Режим «Каскадный VPN» (Cascade VPN): мультипротокольный вход (VLESS Reality, Hysteria 2, Windows SSTP, L2TP/IPsec) → шейпер ядра
tc(HTB/TBF) и групповые профилиnftables(Basic,Restricted,Paranoid) → балансировка на внешние каскадные серверы (Upstream Relay) по протоколам Hy2 и VLESS. - Режим «Корпоративный шлюз» (Corporate Gateway & Site-to-Site): использует собственную независимую БД, изолированные таблицы пользователей, ролей, квот и аудита, отдельные конфиги
sing-box,strongSwan,SSTP/L2TP,nftablesи сертификаты X.509. Поддерживает AD/RADIUS (AAA), выдачу адресов из корпоративной подсети (например,10.20.0.0/24), ACL-матрицу по сегментам (DEV/ERP/DB) и экспорт событий в SIEM / Prometheus.
2. Четыре режима каскадной маршрутизации (без разрыва активных сессий)
Каждая группа пользователей или тарифный план может работать в собственном режиме маршрутизации, причём переключение происходит на лету — без перезапуска активных соединений:
Режимы маршрутизации Apium Cloud OS
Движок каскадированияКак платформа направляет трафик с входного сервера на внешние выходные узлы в зависимости от задачи.
| Режим | Механика работы | Ключевая гарантия | Типовой сценарий |
|---|---|---|---|
| Direct (Zero Hop) | Прямой выход через локальный NAT/MASQUERADE входного сервера | Минимальная сетевая задержка | Однохоповые узлы и локальный прямой выход |
| Auto-Failover (15s) | Непрерывный опрос апстримов по RTT и доступности каждые 15 сек | 99.99% Uptime; мгновенный переход на резерв | Отказоустойчивые магистрали при сбоях апстрима |
| Load Balance | Равномерное (Even) или приоритетное (Priority) распределение сессий | Масштабирование полосы и CPU | Высоконагруженные группы и распределение по пулу узлов |
| Selected Node | Жёсткая привязка группы или тарифа к конкретной локации | Предсказуемый выделенный IP | Банки, платёжные шлюзы, стриминг, IP-allowlist |
3. Раздельное туннелирование (Split Tunneling) и единое квотирование
Раздельное туннелирование в Apium Cloud OS реализовано сразу на двух уровнях в зависимости от типа подключения:
- Маршрутизация по доменам и гео-базам (VLESS Reality / Hysteria 2): гибкие правила
geosite,geoipиCIDRпозволяют пускать доверенный локальный трафик напрямую, а целевые домены или чувствительные направления — через входной шлюз и каскад Upstream Relay. - L3 / Subnet Split Tunneling (Windows SSTP и роутеры L2TP/IPsec): в корпоративном режиме удалённым сотрудникам и филиальным маршрутизаторам (MikroTik, Keenetic) выдаются точечные маршруты в корпоративные подсети (
10.20.0.0/24) и статические IP. Интернет-трафик не нагружает офисный канал, а доступ к сегментамDEV/ERP/DBстрого фильтруется по ACL. - Единый учёт и отключение по квоте: независимо от того, подключился абонент по VLESS, Hysteria 2, SSTP или L2TP, весь трафик агрегируется в единый профиль. При исчерпании лимита или истечении срока доступ отзывается автоматически с разрывом активных сессий, а скорость ограничивается групповым шейпером HTB/TBF.
4. Насколько это отличается от 3X-UI, Marzban, Hiddify, Remnawave и S-UI
Каскадирование и маршрутизация: Apium Cloud OS vs конкуренты
Глубокое сравнениеПочему ручной JSON-outbound в прокси-панели не заменяет полноценную систему каскадирования и корпоративного шлюза.
| Возможность | 3X-UI / Marzban / Remnawave | Hiddify / S-UI / Marzneshin | Apium Cloud OS |
|---|---|---|---|
| Каскад Upstream Relay | ◐ Ручной JSON outbound Xray | ◐ Ручной sing-box / список нод | ✓ Штатный Hy2/VLESS Relay UI + API |
| Auto-Failover с опросом 15s | ✕ Нет встроенного failover | ✕ Только на клиенте / вручную | ✓ Серверный Health-Check 15s |
| Переключение режима на лету | ✕ Перезапуск ядра / глобально | ✕ Требует рестарта ядра | ✓ Direct/Failover/LB/Pin на группу |
| Изоляция Corporate Gateway | ✕ Единая общая БД и конфиг | ✕ Нет корпоративного режима | ✓ Отдельная БД, CA, RADIUS и ACL |
| Шейпер HTB/TBF и nftables | ✕ Только учёт байт (квота) | ✕ Только учёт байт (квота) | ✓ Лимиты Мбит/с + 3-уровн. nftables |
Что в других панелях приходится делать вручную
- Собирать вручную JSON-цепочки outbound в Xray/sing-box и перезапускать ядро при каждой правке (обрывая соединения пользователей).
- Писать собственные bash/cron-скрипты для проверки доступности выходных VPS и переключения маршрутов.
- Отдельно поднимать strongSwan, accel-ppp, RADIUS и правила nftables для роутеров и корпоративных подсетей.
Что даёт Apium Cloud OS из коробки
- Мгновенное переключение групп между Direct, Auto-Failover (15s), Load Balance (Even/Priority) и Selected Node без обрыва сессий.
- Полная изоляция Cascade VPN и Corporate Gateway (раздельные БД, сертификаты CA, ACL-матрицы и экспорт в SIEM / Prometheus).
- Единый учёт трафика, групповой шейпер скорости HTB/TBF и раздельное туннелирование по всем 4 протоколам.
5. Схема работы каскада и резервирования
На схеме ниже показана полная топология взаимодействия: от клиентских устройств и входного шлюза Apium Cloud OS до выходных каскадных узлов в разных странах и локального NAT-выхода:
Как именно это работает
- 1. Единая точка входа для всех типов клиентов: ПК на Windows (нативный SSTP), аппаратные роутеры MikroTik / Keenetic (L2TP/IPsec) и мобильные/десктопные приложения (VLESS Reality / Hysteria 2) подключаются к одному стабильному входному серверу Apium Cloud OS.
- 2. Контроль ядра на входном узле: до отправки трафика в каскад применяются групповые правила
nftables, шейпер скоростиtc(HTB/TBF) и единый учёт квот пользователя. - 3. Опрос узлов каждые 15 секунд и выбор маршрута: движок каскада непрерывно проверяет RTT и доступность выходных серверов разных стран (например, NL → DE → FI). В режиме Auto-Failover при деградации или падении основного узла (NL) потоки автоматически уходят на резервный (DE или FI). В режиме Load Balance нагрузка распределяется между странами (Even или Priority), в Selected Node группа жёстко закреплена за выбранной страной, а Direct выпускает трафик напрямую через локальный NAT.
Ключевые преимущества такой схемы
- Нулевая перенастройка клиентов: при падении зарубежного VPS или смене выходной страны ни пользователям, ни офисным роутерам, ни Windows-клиентам не нужно менять конфиги или адреса подключения.
- Транспортное усиление на магистрали: даже классические протоколы (L2TP/IPsec с роутера или Windows SSTP) между входным сервером и страной выхода передаются по защищённому каналу
Hysteria 2/VLESS. - Независимость групп без обрыва сессий: разные отделы или тарифы на одном сервере Apium могут одновременно работать в разных режимах (
Direct,Auto-Failover,Load Balance,Selected Node) и переключаться на лету.